Google начал раскатывать масштабное обновление, которое существенно усложнило извлечение и парсинг точных URL-адресов из поисковой выдачи (SERP).
Ранее поисковик уже практиковал использование промежуточных редиректов — вместо прямой ссылки подставлялся промежуточный адрес (например, через структуру [google.com/goto?url=](https://google.com/goto?url=)...), однако конечный URL всё равно можно было легко распарсить прямо из исходного кода страницы или атрибутов.
Теперь Google полностью зашифровал адреса страниц. Внутри ссылок с перенаправлением передаётся защищённый зашифрованный токен (хэш/блоб), восстановить или расшифровать который обычными методами анализа кода невозможно. Единственный прямой способ узнать конечную страницу — сделать реальный переход (клик) по этой ссылке.
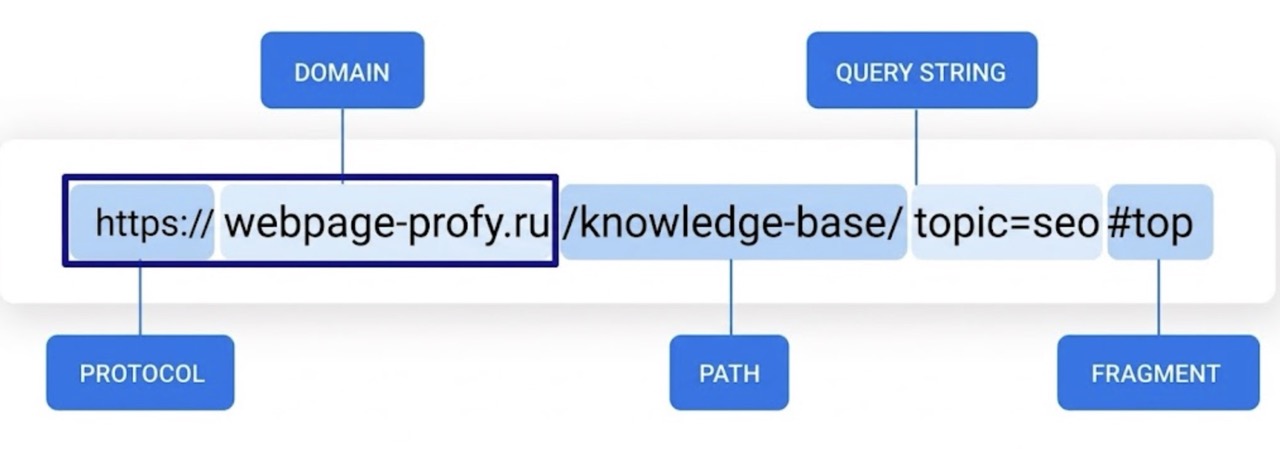
Из HTML-разметки без перехода по ссылке сейчас можно извлечь только домен сайта, но не полный путь к конкретному документу или разделу.
Зачем Google скрывает адреса?
Хотя официальных комментариев от компании пока нет, эксперты связывают эти изменения с несколькими ключевыми факторами:
-
Борьба со скрапингом и парсингом: Ограничение работы сторонних сервисов поисковой аналитики, автоматизированных систем сбора данных и парсеров.
-
Защита данных от сторонних ИИ: Попытка закрыть свободный сбор обучающих выборка и контекста поисковой выдачи сторонними AI-моделями, сохранив полноценный доступ к выдаче только для собственных сервисов Google (включая AI Overviews).
-
Контроль аналитики и поведенческих факторов: Благодаря такой схеме Google может точнее фиксировать переходы и собирать статистику о трафике даже в тех случаях, когда у пользователя отключен JavaScript или используются анонимайзеры.
К чему это приводит?
Для обычных пользователей поисковика ничего не изменилось — клик по результату выдачи по-прежнему приводит на нужный сайт. Однако для автоматизированных систем это создаёт серьёзную нагрузку:
-
Рост затрат на парсинг: Чтобы получить точный URL, инструменту анализа необходимо осуществлять фактический переход по зашифрованному редиректу и обрабатывать HTTP-заголовки ответа (
Location), что кратно увеличивает количество сетевых запросов и ресурсы на обработку. -
Сбои в отслеживании релевантных страниц и индексации: Автоматическая проверка точных адресов ранжирующихся страниц или их статуса в индексе без совершения эмуляции кликов становится временно невозможной или нестабильной.
Способы решения и обходные пути
Определение релевантной страницы по сниппету: Один из наиболее простых и щадящих способов — анализировать текст и заголовок сниппета, выводимого Google. Поисковик формирует сниппет из фрагментов контента целевой страницы, что позволяет сопоставить его с базой страниц сайта или идентифицировать нужный URL по уникальным текстовым пассажам без совершения перехода.
Обработка редиректов на стороне сервера (Follow Redirects): Отправка серверного HTTP-запроса по перехваченной ссылке [google.com/goto](https://google.com/goto)?... с отключённым автоматическим перенаправлением. В этом случае сервер считывает заголовок Location из HTTP 301/302 ответа и сразу получает финальный URL без полновесной загрузки целевого сайта.
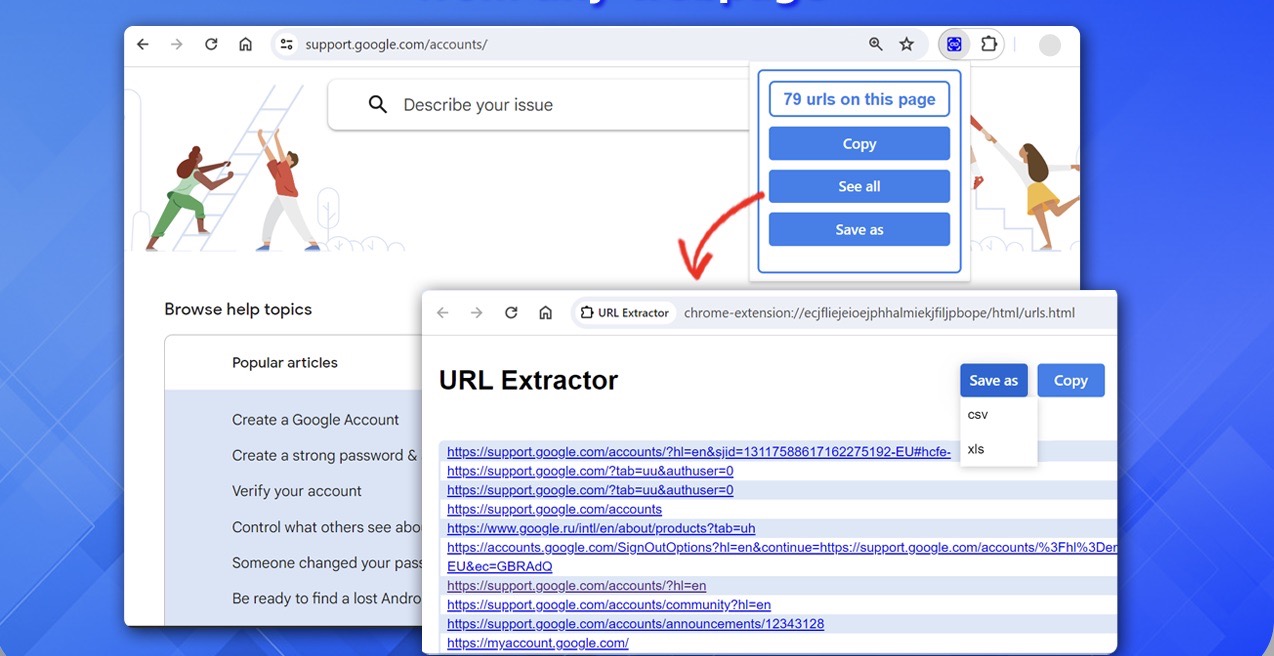
Использование альтернативных интерфейсов (Google Translate / Кеш): Применение технических обходных путей через сервисы Google (например, формирование ссылок через Google Переводчик), где структура целевого адреса в параметрах пока может оставаться неанонимизированной.
Интеграция с официальным API (Google Search Console API): Для задач аналитики своего сайта переход на данные из Search Console API позволяет полностью избежать проблем с шифрованием в SERP, так как сервисы Google отдают точные целевые URL напрямую из первоисточника.